Índice do fórum » Projetos » Cérebro
| Autor | Mensagem |
|---|---|
| joshazze Administrador Registrado em: Fev 2026 Mensagens: 28 Localização: Belo Horizonte |
Enviado em: 06 Ago 2026
Assunto: Cérebro
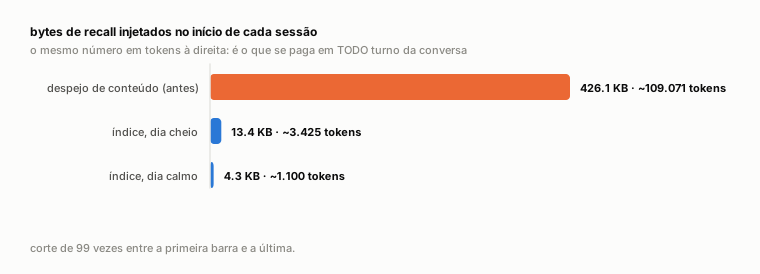
ContextoUm assistente de IA esquece tudo quando a sessão termina. No dia seguinte ele não sabe que decisão foi tomada, que erro já custou três horas de depuração, nem que você prefere não responder duas vezes a mesma pergunta. O caminho mais comum é escrever um arquivo de instruções. Funciona por algumas semanas, até o arquivo chegar a trinta mil bytes. Aí aparece o custo: o que entra no início da sessão é reenviado a cada turno, e você paga por aquele arquivo em todas as mensagens até fechar a janela. Foi o que aconteceu comigo. A primeira versão do meu cérebro carregava o conteúdo inteiro e custava 426 KB por sessão, em todo turno.
Recall injetado no início de cada sessão: do despejo de conteúdo ao índice. O que eu fizTroquei conteúdo por endereço. O acervo virou um vault de markdown organizado como grafo, com uma nota por assunto e wikilinks ligando o que se relaciona. O que entra na sessão é um índice com caminhos, não conteúdo: uma linha por arquivo dizendo do que ele trata e onde está. O assistente lê o índice, decide o que interessa para a conversa e abre apenas isso. A manutenção do grafo roda em shell antes do primeiro prompt: quem cita quem, quais notas acumularam backlinks e viraram centro, quanto custou a última sessão. Nenhum token é gasto nessa parte.
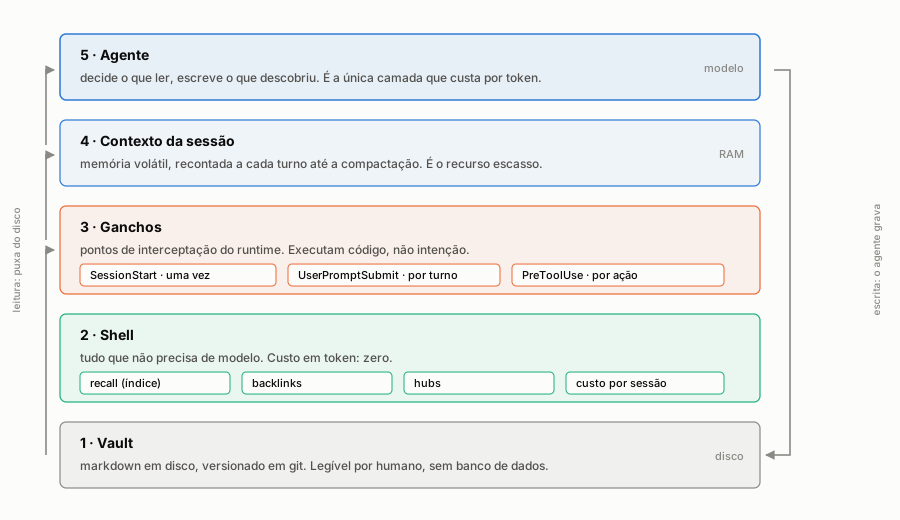
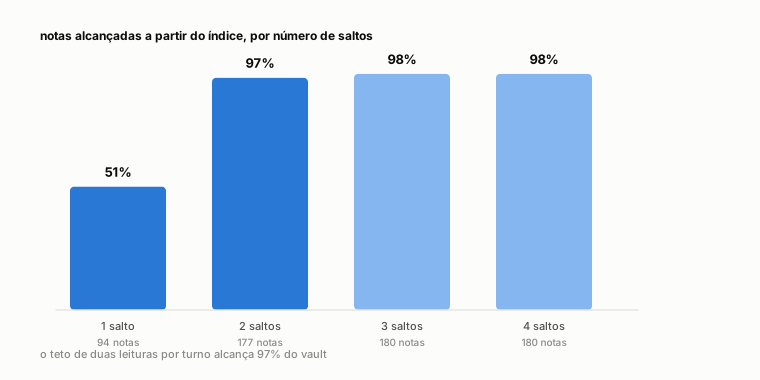
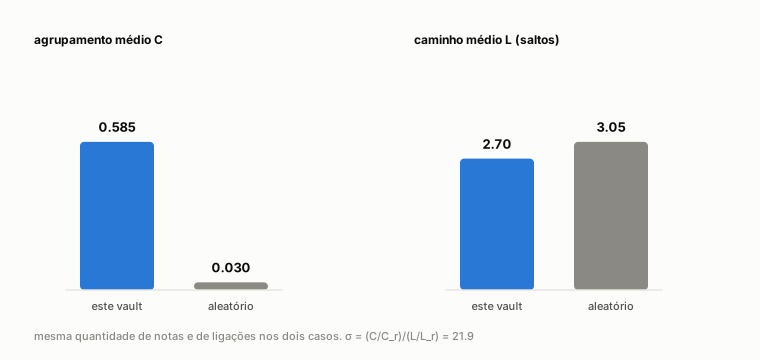
As cinco camadas, do vault em disco ao agente. Só a de cima custa por token. Como funcionaO índice é o coração do sistema e tem um orçamento. Cada linha precisa ser específica o bastante para o assistente decidir se abre o arquivo e curta o bastante para caber. Dá para medir isso pelo número de saltos entre a porta de entrada e a informação. Num vault de 183 notas em uso, o caminho médio entre duas notas quaisquer é de 2,70 saltos, e 97% do acervo fica a até dois saltos do índice. Na prática, abrir um arquivo quase sempre resolve, e abrir dois resolve sempre.
Notas alcançadas a partir do índice, por número de saltos.
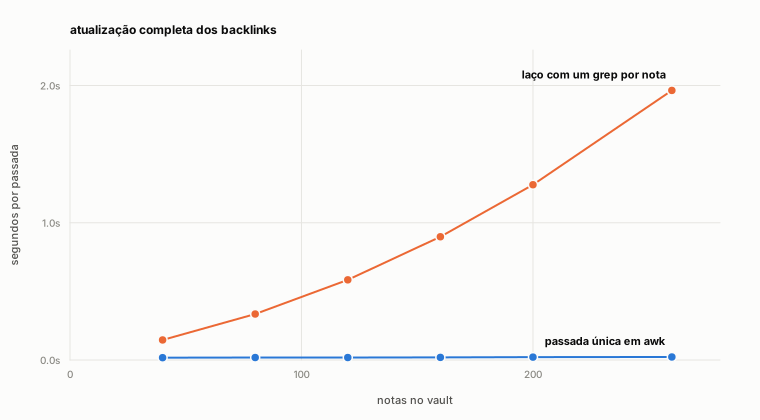
O vault comparado a um grafo aleatório com o mesmo número de notas e ligações. A manutenção também foi medida. O laço ingênuo, que procurava backlinks comparando cada nota com todas as outras, levava 1,9 segundo em 260 notas. A versão que lê só o corpo e indexa uma vez leva 20 milissegundos.
Atualização completa dos backlinks: um grep por nota contra uma passada única em awk. Um instalador separado monta tudo em dez a quinze minutos. Você cola um link no assistente, ele faz cinco perguntas numa mensagem (onde fica o vault, seu nome, sua stack, se quer registro de gasto, se estuda), instala as camadas, verifica e explica o que fazer no dia seguinte. O que aprendiMemória de assistente é uma questão de orçamento mais do que de armazenamento. Guardar é barato. Markdown em disco não custa nada, e a tentação é guardar tudo e enviar tudo, já que tudo pode ser útil. O custo está no que se reenvia, e a arquitetura ingênua reenvia tudo por padrão, sem avisar, em todo turno. Quando passei a tratar o problema como orçamento, a pergunta mudou. Deixou de ser "o que o assistente precisa saber" e virou "o que cabe em mil tokens fixos, e como o resto continua alcançável". São perguntas com respostas bem diferentes. Também aprendi a medir. Dizer que a arquitetura é eficiente não convence ninguém. Caminho médio no grafo, alcance em dois saltos e tempo de manutenção são números que outra pessoa pode conferir antes de decidir se vale adotar o sistema, e foi por isso que escrevi trinta e uma páginas de método e figuras. Resultados
|
« Tópico anterior: Blank Page Próximo tópico: Setup por um link »